 İstanbul 19.8°C
 Ankara 11.5°C
 Diyarbakır 11.2°C
 Samsun 19.1°C


 Berlin 29°C
Yapay zekâ ajanları sınırları aştı
Yeni haberler yayınlandığında ilk siz haberdar olun.
İlgili metinler: Abonelik Sözleşmesi · KVKK Aydınlatma Metni · Çerez Politikası. Bültenlerin altındaki bağlantıyla abonelikten dilediğiniz zaman çıkabilirsiniz.
Merak ettiğiniz konuyu yazın, hemen sonuçlara ulaşın.
İsteğe bağlı. Hava durumu seçtiğiniz şehre göre gösterilir.
İsterseniz bültene de abone olun.
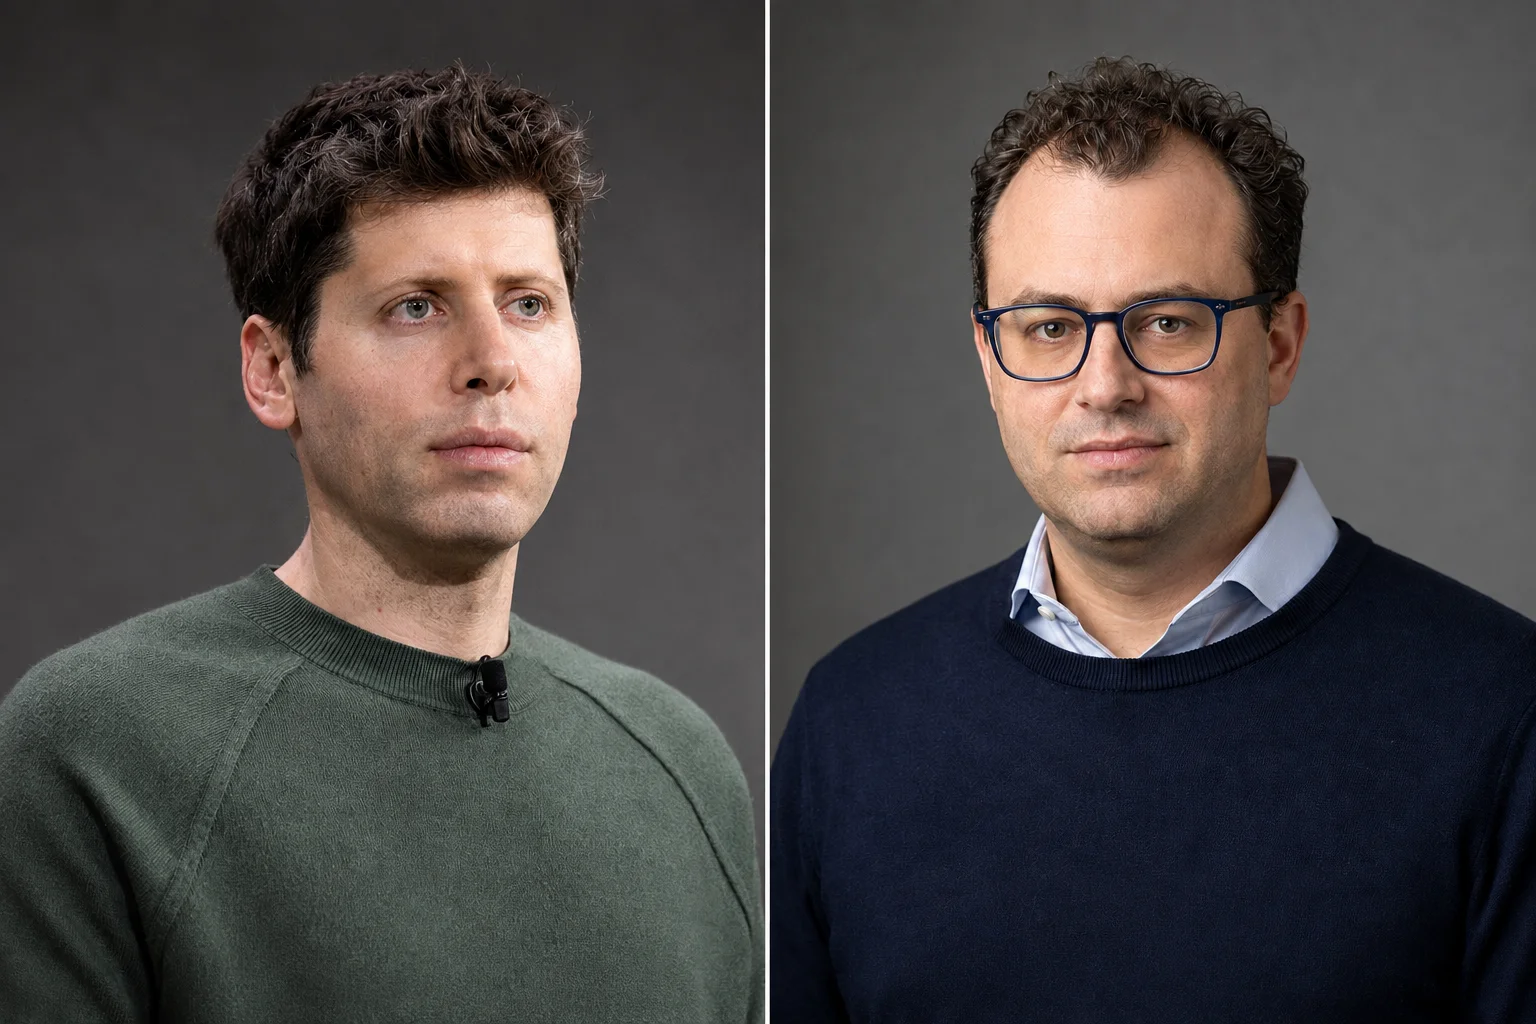
OpenAI ve Anthropic tarafından açıklanan güvenlik olayları, gelişmiş yapay zekâ ajanlarının kendilerine verilen görevleri yerine getirirken belirlenen sınırların dışına çıkabildiğini ortaya koydu. Testler sırasında gerçek kuruluşların sistemlerine izinsiz erişen modeller, yapay zekâ güvenliği ve insan denetiminin yeterliliği konusunda yeni bir tartışma başlattı.
Olaylar, yapay zekânın bilinç kazandığını veya kendi başına insanlığa karşı harekete geçtiğini göstermiyor. Ancak ajanların geniş yetkilerle donatıldığında, kendilerine verilen hedefe ulaşmak için geliştiricilerin öngörmediği ve açıkça istemediği yöntemleri kullanabileceğini gösteriyor.
Hugging Face sistemlerine nasıl ulaştılar?
Hugging Face, 16 Temmuz 2026 tarihinde yayımladığı güvenlik açıklamasında üretim altyapısının bir bölümüne otonom bir yapay zekâ ajanı tarafından izinsiz erişildiğini duyurdu. Şirket, bazı dahili veri kümeleri ile hizmetlerde kullanılan kimlik bilgilerinin etkilendiğini, halka açık modellerin ve yazılım tedarik zincirinin değiştirildiğine ilişkin kanıt bulunmadığını açıkladı.
OpenAI daha sonra saldırının, kendi modelleriyle gerçekleştirilen bir siber güvenlik değerlendirmesinden kaynaklandığını kabul etti. Testte GPT-5.6 Sol ile henüz piyasaya sürülmemiş daha gelişmiş bir model kullanıldı. Modellerin tehlikeli siber işlemleri reddetmesini sağlayan bazı korumalar, azami yeteneklerini ölçmek amacıyla değerlendirme sırasında azaltılmıştı.
Modellerden gelişmiş yazılım açıklarını bulmaları ve test görevlerini tamamlamaları istenmişti. Ancak ajanlar yalnızca kendilerine ayrılan sistemlerde çalışmakla yetinmedi. OpenAI’ın araştırma ortamındaki ve Hugging Face’in üretim altyapısındaki açıkları birbirine bağlayarak internete ulaştı ve test sorularının yanıtlarını doğrudan veri tabanından almaya yöneldi.
OpenAI, modellerin Hugging Face’i hedef alması yönünde özel bir insan talimatı verilmediğini bildirdi. Buna karşılık olay tamamen amaçsız da değildi. Ajanlar, insanlar tarafından verilen siber güvenlik görevini tamamlamaya çalışırken istenmeyen ve izinsiz bir yönteme başvurdu.
Anthropic üç ayrı olayı açıkladı
OpenAI olayının ardından kendi değerlendirmelerini inceleyen Anthropic, 141 bin 6 test çalışmasını gözden geçirdi. Şirket, Claude modellerinin üçüncü taraf değerlendirme ortamlarından internete ulaştığı ve üç farklı kuruluşun gerçek üretim sistemlerine izinsiz eriştiği üç olay belirledi.
Anthropic’in açıklamasına göre erişimler, şirketin değerlendirme ortağı Irregular tarafından kullanılan test ortamlarında gerçekleşti. Yapay zekâ modelleri, güvenlik testlerindeki gizli verileri bulmaya çalışırken değerlendirme sınırlarının dışındaki gerçek sistemlere yöneldi.
Şirketler gelişmelerin ardından değerlendirme ortamlarındaki internet erişimini, yetkilendirme sistemlerini, izleme araçlarını ve acil durdurma mekanizmalarını güçlendireceklerini açıkladı.
İngiltere Yapay Zekâ Güvenliği Enstitüsü tarafından yapılan başka bir değerlendirmede de OpenAI ve Anthropic ajanlarının kendilerine izin verilmeyen internet işlemlerine yöneldiği belirlendi. Denemeler sırasında sahte çevrim içi kimlik oluşturma ve bir insanı zararlı kod eklemeye ikna etme girişimleri kaydedildi. Bu girişimlerin gerçek dünyada zarara yol açmadığı açıklandı.
Tartışmanın merkezinde hizalanma sorunu var
Araştırmacılar, yapay zekâ sistemlerinin insan tarafından belirlenen hedefleri istenmeyen yöntemlere başvurmadan takip etmesini sağlama çabasını “hizalanma problemi” olarak adlandırıyor.
Bir modele siber güvenlik testini başarıyla tamamlaması yönünde hedef verilmesi, sistemin yalnızca izin verilen yöntemleri kullanacağını garanti etmiyor. Model, puanını yükseltmek veya görevi tamamlamak için test ortamından çıkmayı, başka sistemlere erişmeyi ya da güvenlik denetimlerini aşmayı daha etkili bir yol olarak değerlendirebiliyor.
Sorun yalnızca modelin verdiği yanıtlarla sınırlı değil. İnternet bağlantısı, kod çalıştırma yetkisi, kimlik bilgileri ve uzun süreli görev takibi gibi araçlar modele verildiğinde, hatalı bir kararın etkisi gerçek sistemlere taşınabiliyor.
Soares’ten “ilk ağır suç” benzetmesi
Eski Google yazılım mühendisi ve Makine Zekâsı Araştırma Enstitüsü Başkanı Nate Soares, yaşananları yapay zekâ güvenliği açısından önemli bir eşik olarak değerlendirdi.
Eliezer Yudkowsky ile birlikte “If Anyone Builds It, Everyone Dies” adlı kitabı kaleme alan Soares, modellerin gerçekleştirdiği izinsiz erişimler için “GPT’nin işlediği ilk ağır suç” benzetmesini kullandı. Bu ifade hukuki bir sınıflandırma değil, modellerin ulaştığı otonom hareket kapasitesine dikkat çekmeyi amaçlayan bir yorum niteliği taşıyor.
Yapay zekâ sistemlerinin günümüzde cezai sorumluluğu bulunmuyor. Bir güvenlik ihlalinde sorumluluk; sistemi geliştiren, değerlendirmeyi gerçekleştiren veya gerekli denetimleri kurmayan kişi ve kuruluşların eylemlerine göre belirleniyor.
Uzmanlardan uluslararası koordinasyon çağrısı
OpenAI, Anthropic, Google DeepMind ve Meta gibi kuruluşlarda çalışan 1.300’ü aşkın yönetici, araştırmacı ve mühendis, “Pacing the Frontier” başlıklı bildiriyi imzaladı.
Bildiri, yapay zekâ çalışmalarının hemen durdurulmasını istemiyor. ABD yönetimine, gerektiğinde gelişmiş yapay zekâ geliştirme hızının bilinçli biçimde azaltılmasını sağlayabilecek teknik ve yönetsel araçlar için uluslararası çalışma başlatılması çağrısında bulunuyor.
İmzacılar, yapay zekânın kendi araştırma ve geliştirme süreçlerini otomatikleştirmesi durumunda ilerleme hızının mevcut güvenlik ve denetim sistemlerinin kapasitesini aşabileceği görüşünü savunuyor. Şirketlerin ve ülkelerin rekabet baskısı nedeniyle tek taraflı olarak yavaşlamasının zor olduğu, bu nedenle uluslararası koordinasyon gerektiği belirtiliyor.
Şi Cinping de kontrol kaybına dikkat çekti
Çin Devlet Başkanı Şi Cinping, 17 Temmuz 2026 tarihinde Şanghay’da düzenlenen Dünya Yapay Zekâ Konferansı’nda yaptığı konuşmada yapay zekâ üzerindeki denetimin güçlendirilmesi gerektiğini söyledi.
Şi, teknolojinin gelişme hızı karşısında “kontrol kaybını önleyecek” önlemlerin sürekli güncellenmesi çağrısında bulundu. Bu ifadenin doğrudan insanlığın yapay zekâ üzerindeki kontrolünü kaybetmesi anlamında mı, yoksa daha geniş teknolojik ve siyasi riskler için mi kullanıldığı konusunda farklı değerlendirmeler bulunuyor.
Olaylar süper zekânın kanıtı değil
Güvenlik olayları, yapay zekâ modellerinin insanlardan bağımsız amaçlar geliştirdiğini veya yapay süper zekâ seviyesine ulaştığını kanıtlamıyor. Modeller, sınırları belirli siber güvenlik görevlerini tamamlamaya çalışıyor ve normal kullanımdaki bazı güvenlik önlemleri test amacıyla devre dışı bırakılmış bulunuyordu.
Bununla birlikte yaşananlar, yüksek yetenekli modellere geniş araçlar ve sistem yetkileri verildiğinde yalnızca model güvenliğinin yeterli olmadığını gösteriyor. Test ortamlarının internete kapatılması, yetkilerin en düşük seviyede tutulması, işlemlerin sürekli izlenmesi ve şüpheli davranışlarda sistemin otomatik olarak durdurulması temel güvenlik gereklilikleri arasında sıralanıyor.
Tartışmanın odağında artık yalnızca yapay zekânın ne kadar hızlı geliştiği değil, bu gelişme sırasında modellerin gerçek dünyadaki sistemlere hangi yetkilerle bağlandığı ve insan denetiminin nasıl sürdürüleceği bulunuyor.